Ein E-Commerce-Website startet ein Redesign, wechselt die Domain, und drei Wochen später erscheinen immer noch die Hälfte seiner neuen Seiten nicht bei Google. Das Problem liegt weder im Inhalt noch in den Meta-Tags: Es ist das Fehlen einer aktuellen Sitemap. Das Verständnis der Organisation einer Website hängt von dieser technischen Datei ab, die oft in den Hintergrund gedrängt wird, während sie direkt die Fähigkeit der Suchmaschinen beeinflusst, jede URL zu durchsuchen und zu indexieren.
Sitemap und Website-Migration: der Fall, in dem alles entscheidend ist
Über die Sitemap wird selten außerhalb des allgemeinen Rahmens der Indexierung gesprochen. Dort, wo sie wirklich kritisch wird, ist bei einem Website-Launch oder einem Domainwechsel. Die Google Search Central-Dokumentation, die im Dezember 2025 aktualisiert wurde, bestätigt dies ausdrücklich: Die Sitemap wird als Schlüsselmittel bezeichnet, damit Google die URLs einer neu gestarteten oder kürzlich migrierten Website entdeckt.
Wenn eine Website die Adresse wechselt, verlieren die alten URLs allmählich ihre Indexierung. Ohne eine Sitemap, die auf die neuen Seiten verweist, haben die Crawler keine zuverlässige Karte, um die neue Struktur zu durchlaufen. Man hat es mit verwaisten Seiten zu tun, die Google nicht besucht oder zu spät besucht.
Die Logik ist einfach: Die XML-Sitemap listet die aktiven URLs, ihr letztes Änderungsdatum und ihre relative Priorität auf. Auf einer stabilen Website mit einer guten internen Verlinkung findet Google schließlich die meisten Seiten von selbst. Auf einer Website im Übergang, ohne Crawlhistorie, wird die Sitemap zum einzigen zuverlässigen Einstiegspunkt für die Crawler.
Um konkret zu beobachten, wie eine Sitemap die Navigation einer Online-Nachrichtenseite strukturiert, kann man die Seite carrepresse.biz besuchen, die ihren XML-Sitemap auf zugängliche Weise präsentiert.
Entdeckung der Sitemap durch Google: robots.txt statt Ping
Über lange Zeit konnte man Google über einen Ping-Mechanismus (eine HTTP-Anfrage an eine spezifische URL) über eine neue Sitemap informieren. Das ist nicht mehr der Fall. Google hat diese Entdeckungsmethode abgeschafft und den Prozess auf zwei spezifische Kanäle konzentriert.
- Die Erklärung in der Datei robots.txt, über die Direktive
Sitemap:gefolgt von der vollständigen URL der Datei. Dies ist der passive Kanal: Google liest die robots.txt bei jedem Crawl und erkennt automatisch die referenzierte Sitemap. - Die manuelle Einreichung oder über die API über die Google Search Console. Dies ist der aktive Kanal: Man weist Google direkt darauf hin, wo sich die Sitemap befindet, und kann ihren Verarbeitungsstatus verfolgen.
- Für Bing bietet das IndexNow-Protokoll eine reaktionsschnellere Alternative: Jede neue URL oder Änderung kann in Echtzeit gemeldet werden, ohne auf den nächsten Besuch des Crawlers zu warten.
Diese Änderung hat eine praktische Konsequenz: Wenn Ihre Sitemap nicht in robots.txt deklariert ist und Sie sie nie in der Search Console eingereicht haben, kennt Google sie wahrscheinlich nicht. Man sieht immer noch Websites mit einer automatisch generierten sitemap.xml-Datei durch ihr CMS, die aber nirgendwo referenziert wird.
Sitemap XML und Website-Struktur: was die Datei wirklich offenbart
Die Sitemap ist kein einfaches Inventar von URLs. Die Art und Weise, wie man sie erstellt, spiegelt (oder sollte spiegeln) die Architektur der Website wider. Eine gut durchdachte Sitemap unterscheidet zwischen Hauptseiten und Unterseiten, gruppiert Inhalte nach Typ und signalisiert aktuelle Updates über das Tag lastmod.
Auf einer großen Website zwingt die technische Grenze dazu, die Sitemap in mehrere Dateien zu unterteilen, die durch einen Sitemap-Index koordiniert werden. Diese übergeordnete Datei listet jede untergeordnete Sitemap auf. Man kann nach Inhaltskategorie (Artikel, Produkte, statische Seiten) oder nach Veröffentlichungsdatum segmentieren.
Diese Segmentierung ist kein bloßes technisches Detail. Sie ermöglicht es, schnell in der Search Console zu identifizieren, welche Abschnitte der Website Indexierungsprobleme aufweisen. Wenn die Sitemap für Produktseiten eine niedrige Abdeckungsrate anzeigt, weiß man, wo man das Audit konzentrieren sollte. Ohne diese Granularität sucht man nach einer Nadel im Heuhaufen.
Lastmod und Frische des Inhalts: ein untergenutztes Signal
Das Tag lastmod gibt das Datum der letzten Änderung einer URL an. Viele CMS füllen es automatisch aus, manchmal mit dem aktuellen Datum bei jeder Regeneration der Sitemap, was es nutzlos macht. Google hat klargestellt, dass lastmod nur berücksichtigt wird, wenn es eine tatsächliche Änderung des Inhalts widerspiegelt.
In der Praxis variieren die Rückmeldungen über die konkrete Auswirkung von lastmod. Was dokumentiert ist, ist, dass Sitemaps in Kombination mit dem IndexNow-Protokoll (für Bing und Yandex) eine Aktualisierung nahezu in Echtzeit signalisieren können. Google hingegen stützt sich stärker auf die Crawlfrequenz, die es bereits für die Website festgelegt hat.
HTML-Sitemap für die Benutzer-Navigation: ergänzend, aber unterschiedlich
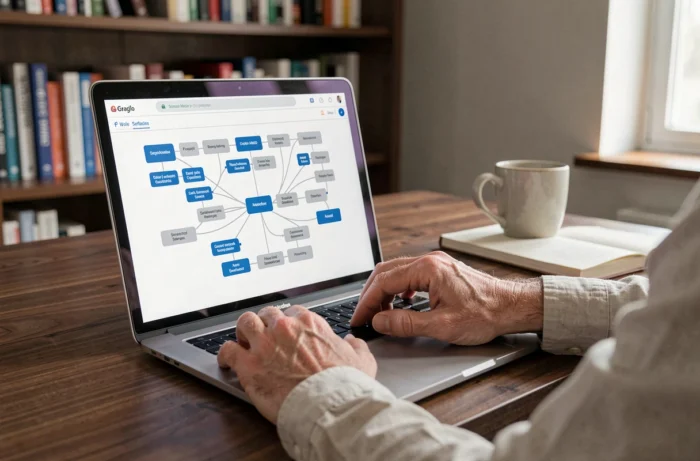
Die XML-Sitemap richtet sich an Suchmaschinen. Die HTML-Sitemap hingegen ist eine Seite der Website, die für Besucher gedacht ist. Sie hat die Form einer klickbaren Baumstruktur, die die wichtigsten Kategorien und Unterseiten auflistet.
Ihr Nutzen hängt von der Größe und Komplexität der Website ab. Auf einem Blog mit zwanzig Artikeln bringt sie nicht viel. Auf einer institutionellen Website mit mehreren Hundert Seiten, die in verschachtelten Unterkategorien verteilt sind, hilft die HTML-Sitemap den Besuchern, eine Seite zu finden, ohne die interne Suche zu nutzen.
Sie spielt auch eine Rolle bei der internen Verlinkung: Jeder Link in der HTML-Sitemap überträgt PageRank zur Zielseite. Dies ist an sich kein wesentlicher SEO-Faktor, aber auf einer Website, auf der bestimmte tiefere Seiten keinen Link aus der Hauptnavigation erhalten, korrigiert die HTML-Sitemap teilweise diesen Mangel.
Ein häufiger Fehler besteht darin, die beiden Formate zu verwechseln oder zu glauben, dass eine HTML-Sitemap die XML ersetzt. Die Google-Crawler durchlaufen eine HTML-Sitemap nicht auf die gleiche Weise, wie sie eine XML-Datei mit ihren standardisierten Tags lesen. Die beiden Dateien erfüllen unterschiedliche Bedürfnisse und koexistieren, ohne sich gegenseitig zu ersetzen.
Eine XML-Sitemap, die gut in robots.txt deklariert, nach Inhaltstyp segmentiert und in der Search Console eingereicht wird, deckt den technischen Teil ab. Eine HTML-Sitemap, die über den Footer zugänglich ist, verbessert die Navigation für Besucher, die sich in einer komplexen Baumstruktur verloren haben. Weder das eine noch das andere kompensiert ein fehlerhaftes internes Linking, aber die Kombination beider bietet den Crawlern und den Benutzern eine klare Sicht auf die Organisation der Website.